Self Attention
https://zenn.dev/knowhere_imai/articles/1008252132d315
この記事では、BERTやGPTなどのAIモデルで使用されているSelf-Attentionネットワークについて説明します。
TransformerやEncoder層・Decoder層、Transformer以外のAttentionの説明などは一切省略し、Self-Attentionにだけフォーカスしました。 その代わり、Self-Attentionについては「完全に理解した」と感じてもらえるように頑張って解説していきます。
なお、同一の名称でマイナーチェンジされた他のネットワークがあるかもしれませんが、本稿で説明する各種Attentionネットワークは全てAll You Need Is Attentionで定義されているものを指します。
全体像

Self-AttentionはMulti-Head Attentionというネットワークの特殊化です。
Multi-Head AttentionはScaled Dot-Product Attentionというネットワークの拡張です。
また、様々な記事で単語同士の関連性が云々などと解説されているのは、実はScaled Dot-Product Attention自体の仕組みや機能の部分です。
よって、Scaled Dot-Product Attentionを把握できれば、Self-Attentionの気持ちは大体理解できるはずです。Multi-Head AttentionやSelf-Attentionに至る拡張や特殊化は、その後に理解していきましょう。
Scaled Dot-Product Attention
一言で述べると、Scaled Dot-Product Attention は、 Key ベクトルと Value ベクトルのペアからなる辞書に対して、 Value ベクトルの加重平均を計算するネットワーク です。 加重平均は、Queryベクトル1つごとに、QueryにマッチするKeyのValueほど大きな重みを持つように計算します。
最初に最低限の構造を頭に入れる
Scaled Dot-Product Attentionは、実は学習用のパラメータを持たない、入力された行列同士を単に演算するだけのネットワークです。
ミニバッチまで考慮すると入力は階数3のテンソルですが、多くの解説記事と同様に、1サンプル分の行列を入力として説明していきます。 また、理解を助けるために、以下では「行列」の代わりに「ベクトルの配列」という表現を用いる場合があります。 1 つの行が(横)ベクトルで、 1 行目 2 行目... がそれぞれ 1 ベクトル目 2 ベクトル目です。
さて、具体的には、 Scaled Dot-Product Attention は、 Q,K,V と表される3つの行列を入力に取り、1つの行列を出力します。
- Q は Query と呼ばれ、長さ dQ のベクトルを N 個並べた行列です。
- K は Keyと呼ばれ、長さ dK のベクトルを M 個並べた行列です。
- V は Value と呼ばれ、長さ dV のベクトルを M 個並べた行列です。
- 出力は、長さ dV のベクトルを N 個並べた行列です。
- ベクトルの長さは dQ = dKである必要があります。
計算の気持ちを理解するにはまずは最低限これだけ覚えれば十分です。

計算の気持ちを理解する
Scaled Dot-Product Attentionが何を計算しているかをざっくりと表すと、以下のようになります。 なお、多くの解説記事では単語の埋め込み表現ベクトルを用いた例がほとんどですが、より気持ちが分かりやすいと思われる別の例で説明します。
KeyとValueの気持ち
まず、KeyとValueは、実数ベクトル型に限定されてはいますが、IT全般でよく使われる辞書データそのものです。
実際に使われているかやメリットがあるかはさておき、理論的には、Scaled Dot-Product Attentionの用途はNLPには限られません。
今回は、 M 人の小中学生について、身長・体重・年齢の3つ(すなわち dK = 3 )の値からなる Key ベクトルと、数学と英語科目の共通テストの点数の2つ(すなわち dV = 2 )の値からなる Value ベクトルがペアになったデータを例に説明をしていきましょう。
| ID | Key (身長, 体重, 年齢) | Value (数学, 英語) |
|---|---|---|
| 0 | K0 = (131.5, 29.6, 8.9) | V0 = (12, 31) |
| 1 | K1 = (151.2, 42.3, 12.8) | V1 = (45, 51) |
| 2 | K2 = (154.3, 47.5, 14.2) | V2 = (52, 78) |
| ... | ... | ... |
他にも、text2imageやvoice2textなど、原理的にはなんでもありです。
出力行列の気持ち
Scaled Dot-Product Attention の出力は、Query ベクトル一つずつごとに、Value 行列の各ベクトルを加重平均したベクトルの配列です。 これは、 Query すなわち「質問」によってKeyベクトルの配列を柔らかくフィルタリングするイメージです。 出力のサイズは長さ dV のベクトルを N 個並べた行列になります。
すぐあとで厳密に説明しますが、まずはざっくりとしたイメージで説明すると
| (ID) | Query | 出力 (数学, 英語) | 重み |
|---|---|---|---|
| 0 | Q0 = 身長の高い生徒の点数は? | w0,0 V0 + w0,1 V1 + w0,2 V2 | 身長の高い i ほど w0,i が高くなるよう Q0 と K から重みを計算 |
| 1 | Q1 = 体重の軽い生徒の点数は? | w1,0 V0 + w1,1 V1 + w1,2 V2 | 体重の軽い i ほど w1,i が高くなるよう Q1 と K から重みを計算 |
| ... | ... | ... | ... |
重みの計算の気持ち
加重平均の重み AM = { wi,j } は、 Q と K によって計算されます。具合的な計算式は

です。
softmax や行列積の定義については説明を省略しますが、
ベクトルの配列からなる行列 Q, K について、 QKT の i,j 成分は Q の i 番目のベクトルと K の j 番目のベクトルのドット積です。
softmaxは、大小関係を変えないまま、各行ごとに列成分を足すと100%になるように変換する演算です。
これらをまとめて、QueryベクトルとKeyベクトルのドット積(dot product)が大きいほど重みも大きくなることだけわかれば十分です。
ドット積が大きいほど重みが大きくなるということは、ドット積の定義より
- ノルムの大きいKeyベクトルほど重みが大きくなる。
- QueryベクトルとKeyベクトルのなす角が小さいほど重みは大きくなる。
ということです。 直観的にはQueryベクトルに似たKeyベクトルほど大きい重みを持つと考えられますが、コサイン類似度とは異なり、ベクトルの方向だけでなく大きさにも影響されることに注意してください。
なお、ノルムの大きいQueryベクトルでもドット積は大きくなりますが、全てのKeyベクトルとのドット積に同じノルムが掛けられるため、Queryベクトルが大きいほど、 softmax を取る際に内積の大きなKeyベクトルの重みの比率が大きくなります。
上の、身長・体重・年齢とテストの点数の例について、
- Queryベクトル Q0 = (1, 0, 0) は身長の大きいKeyに大きい重みを与えます。
- Queryベクトル Q1 = (0, −1, 0) は体重の小さいKeyに大きい重みを与えます。
- Queryベクトル Q2′ = (1, 0, 1) は身長と年齢の大きいKeyに大きい重みを与えます。ただし、 Key 行列の身長と年齢の値のスケールが異なるため、身長と年齢を均等に評価するには Q2 = (0.1, 0, 1) くらいが良いかもしれません。
- Queryベクトル Q3 = (0.05, 0, 0.5) = 0.5 * Q2 だとどうなるでしょうか?
はAttention Matrixと呼ばれています。 この行列は、Queryベクトルごとに、どのKeyベクトルの重みが高いか=どのKeyベクトルに注目をしているかを表現しています。
上の例について、行列積 QKT の各成分は以下のようになります。
| Query/Key | K0 = (131.5, 29.6, 8.9) | K1 = (151.2, 42.3, 12.8) | K2 = (154.3, 47.5, 14.2) |
|---|---|---|---|
| Q0 = (1, 0, 0) | 131.5 | 151.2 | 154.3 |
| Q1 = (0, −1, 0) | −29.6 | −42.3 | −47.5 |
| Q2 = (0.1, 0, 1) | 22.05 | 27.92 | 29.63 |
| Q3 = (0.05, 0, 0.5) | 11.025 | 13.96 | 14.815 |
また、Attention Matrixは以下のようになります(端数は丸めた近似値)。
| Query/Key | K0 = (131.5, 29.6, 8.9) | K1 = (151.2, 42.3, 12.8) | K2 = (154.3, 47.5, 14.2) |
|---|---|---|---|
| Q0 = (1, 0, 0) | 0% | 4.3% | 95.7% |
| Q1 = (0, −1, 0) | 100% | 0% | 0% |
| Q2 = (0.1, 0, 1) | 0% | 15% | 85% |
| Q3 = (0.05, 0, 0.5) | 1.5% | 29.5% | 69% |
- Q0 では最も高身長の Key の重みが高いです。
- Q1 では最も体重の軽い Key の重みが高いです。
- Q2 ではほぼ同身長の K1 と K2 のうち、年齢の高い K2 の方が大きな重みを持っています。
- Q3 = 0.5 Q2 では、 K2 の重みが最も高いことには変わりませんが、 Q2 よりもマイルドな重み付けになっています。
ここまでの解説と一致していることがご理解いただけるのではないでしょうか。
Scaled Dot-Product Attention全体の計算式は

です。 All You Need Is Attention の 4P の式 (1) です。これは最初に述べた通り、 Attention Matrix の i 行 j 列の成分を i 番目の Query と j 番目の Key の重みとして、 Value の加重平均を計算する式です。
ネットワーク
参考までに、Scaled Dot-Product Attentionのネットワークを図で示すと以下のようになります。
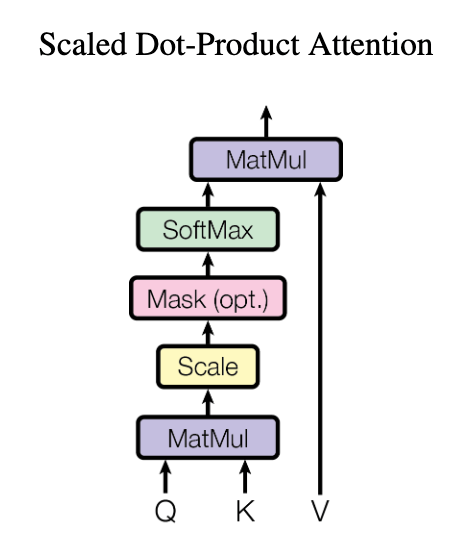
MaskはTransformerの学習時に使用されますが、Scaled Dot-Product Attention単体には直接関係ないため、本稿では解説しません。
Multi-Head Attention
Multi-Head AttentionはScaled Dot-Product Attentionを複数個重ねたネットワークです。まずは図で見てもらうのが良いでしょう。
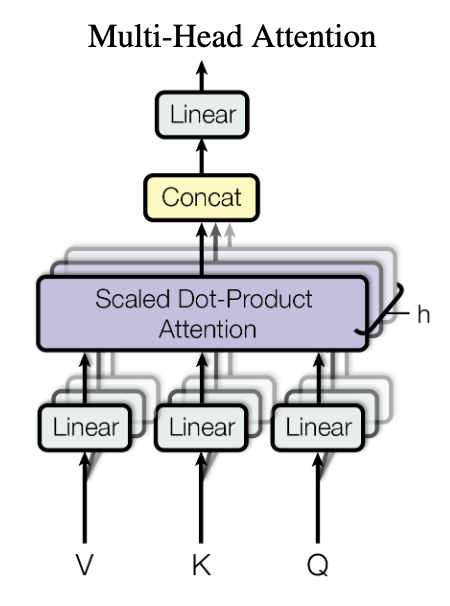
各Scaled Dot-Product Attention(またはその手前の線形変換層を含めて?)はHeadと呼ばれています。 これが複数あるため「Multi-Head」Attentionです。
各Scaled Dot-Product Attentionへの入力行列は、 Multi-Head Attention への入力行列 Q, K, Vに線形変換(アフィン変換だけど深層学習界隈だと線形変換と呼ばれている)を適用した行列です。 これは、学習パラメータを持たないScaled Dot-Product Attentionに全く同じ行列を入力しても意味がないからというだけでなく、QueryとKey(が表したいもの)の各ペアが複数の関係性を持ちうる場合に、Headごとに個別の関係性を表現するために有効と考えられています。
言語を例に説明するのがわかりやすいでしょう。
ある文中の単語同士のペアについて、何か意味的に関係のあるペアを抽出したいとします。 しかし、文中の各単語ペアは以下の例のような様々な関係を持ちうるため、何か一つの観点だけの抽出では文の意味全体をうまく捉えることができなくなってしまいます。
- 修飾・被修飾の関係
- 類義語・反意語の関係
- 異なる代名詞(itやyouなど)が同じ実体を指し示す関係、etc
各Headの最初の線形変換でMulti-Head Attention全体への入力からそのHeadが着目している関係性の成分を抽出し、Headごとに別々のAttention Matrixを計算することで、Multi-Head Attentionは複雑な性質を持つデータをうまく処理しているものと考えることができます。
何を意味しているかを読み取るのは難しいですが、実際に言語で訓練したネットワークについて、同一の入力に対して二つのHeadのAttention Matrixが異なる注目をしていることを確認した例があります。
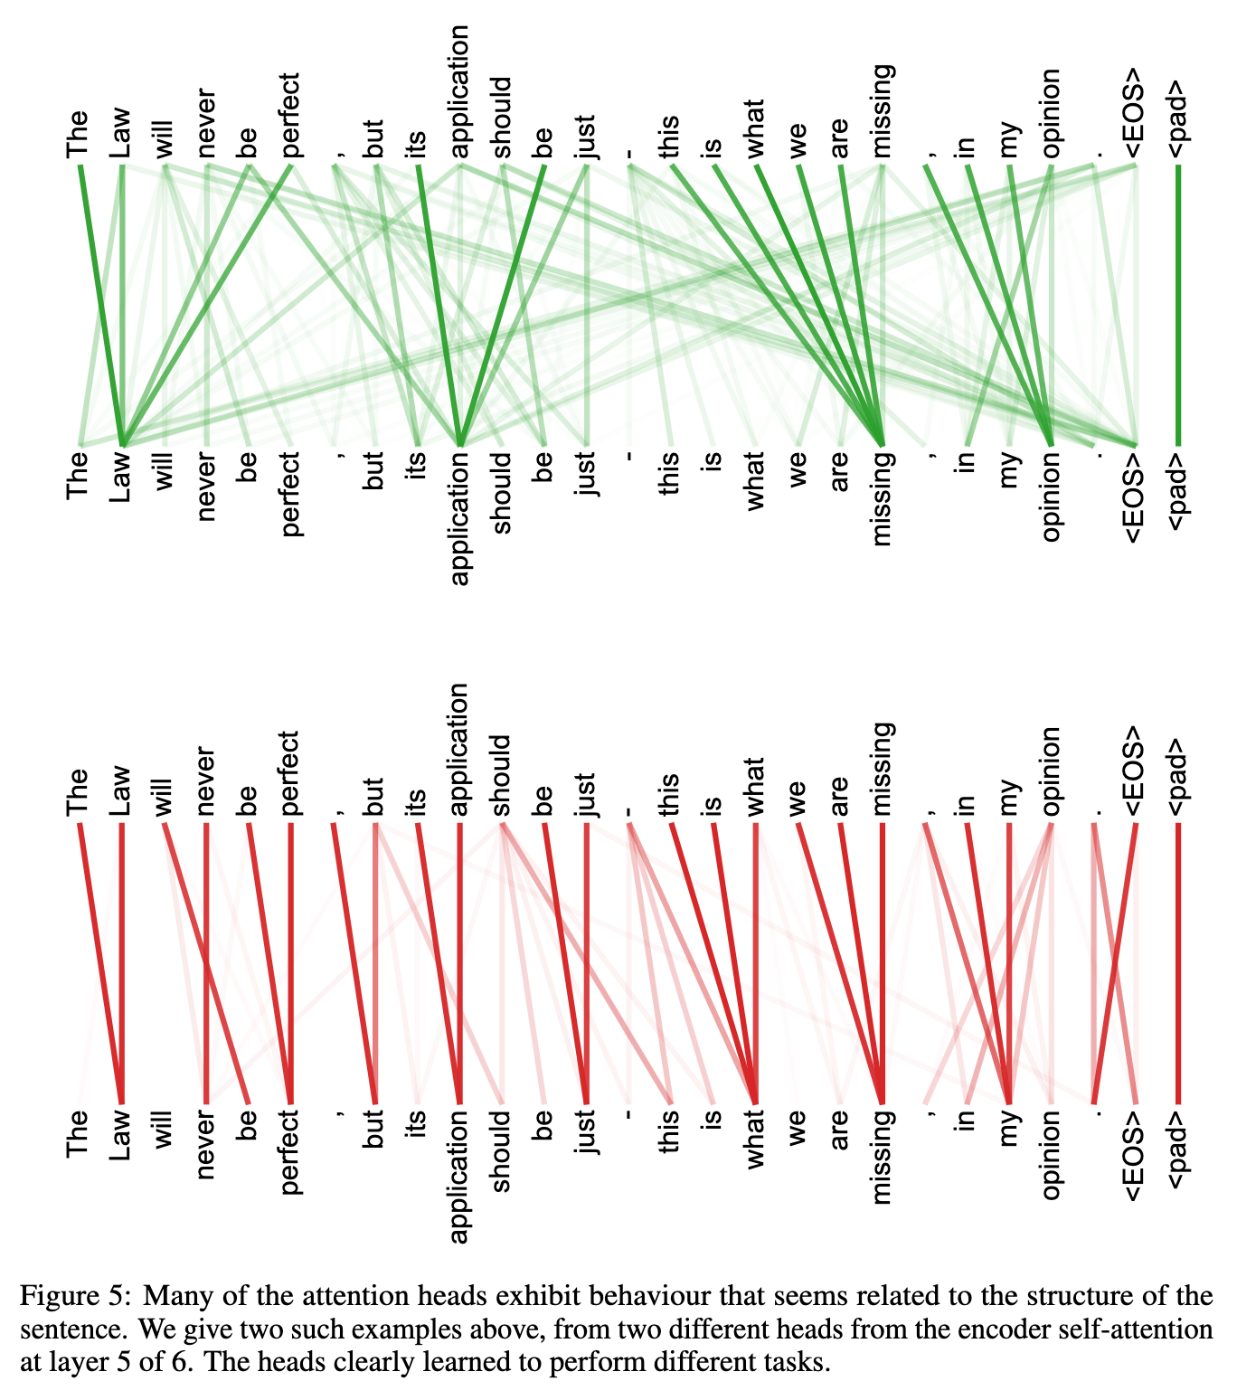
ただし、複数のHeadは、異なる関係性を捉える余地・可能性を生み出しているだけであり、この構造であればいかなる場合にも異なる関係性を学習するわけではない、ということに注意してください。 多チャネルのConvolutionなどでも同様ですが、実際に訓練を行うと各Headがほぼ同じ重みを学習することもあります。損 失関数などを工夫することで、学習パラメータの多様性を促進する仕組みなども研究されているようです。
最後に、各Headの出力はConcatつまり単純に重ねられた後に線形変換されて出力されます。 h 個のHeadがある場合、各Headの出力ベクトルの長さが dV′ であるならば=入力側の線形変換で V が長さ dV′ のベクトルの配列に変換されたのであれば、Concat後の全体の長さは h × dV′ になります。 Concat直後のベクトルは、 dV′ 個の成分ごとに各Headの観点に対応した別々の意味を持つようなベクトルになっています。
Self-Attention
ここまでしっかりと理解できれば後は簡単です。 Self-Attentionは、単一の行列を入力として、 Q = K = V で計算を行う Multi-Head Attention です。
Q = K であることから、各 Head の Attention Matrix AM = { wi,j} は次のようになります。
- NLPにおいて、単語 i と単語 j に(その Head の観点において)強い関係性がある場合に wi,j が高くなる。
- 時系列データにおいて、時刻 i と時刻 j のデータに強い関係性がある場合に wi,j が高くなる。
- 人間の計測データにおいて、人 i と人 j のデータに強い関係性がある場合に wi,j が高くなる。
上記の AM に更に V に掛けることから、各 Head の出力 AM × V は次のようになります。
- NLPにおいて、 i 番目の出力ベクトルは、単語 i に(その Head の観点において)強い関係性を持つ単語 j の Vj の加重平均。
- 時系列データにおいて、 i 番目の出力ベクトルは、時刻 i のデータに強い関係性を持つ時刻 j の Vj の加重平均。
- 人の計測データにおいて、 i 番目の出力ベクトルは、人 i のデータに強い関係性を持つ人 j の Vj の加重平均。
ちなみに、Self-Attentionにおいても、各 Head の Attention Matrix は一般的には非対称行列です。 大元の入力行列は同じでも、各 Head で Scaled Dot-Product Attention を実行する前に、 Q と K に別々の線形変換を施しているためです。
Transformer全体が何を計算しているのかを解釈するのは更に難しいですが、ひとまず単一のSelf-Attentionが何を計算しているのかはこのようなイメージです。
サイズパラメータについて
Self-Attention 単体の解説としてはこのくらいですが、これを Transformer 内で重ねて使うためには、特にサイズ周りのパラメータについて、いくつかのコツあるいは必要条件があります。
- 同一のサイズでなければいけない制約
- 勾配発散を防ぐためのスケーリング
- ドット積の次元の呪いの防止
- etc...
拙著ではありませんが、例えば次の記事などで詳しく解説されていますのでご興味があれば参考にしてみてください。